
从一个ai辩论应用开始
这几天突发奇想,想做一个ai辩论的应用,来测试各个模型对于一个辩题的碰撞情况。一开始只是图有意思,这个应用本身只是对模型训练的世界知识的测试,并没有测试模型强度的用途。但由这个应用的思想上,觉得有一些地方是值得参考的,据此可以做一些更有意义和价值的东西。
从 AI 辩论到通用问题解决工作流
起初只是我突发奇想:能不能让 AI 自己围绕一个议题进行辩论?
于是我设计了这样一套机制:
- 分为正方辩手和反方辩手;
- 每一方内部形成一个小组;
- 每一轮辩论中,组内成员可以自由发表观点、相互讨论;
- 最终在组内达成一致,并输出该轮本方的最终论点。
同时设立一个裁判角色。
裁判负责判断这一轮辩论是否有效,例如是否偏题、论点是否符合当前辩论要求等。
如果裁判认为该轮存在问题,可以根据实际情况撤销当前论点,并要求该方重新发表。
如果裁判认为该轮没有明显问题,则切换辩手,由另一方继续进行辩论。
整个项目基于我自己的 Agent Framework 开发。
对我来说,它也算是一个用于学习 Harness 的项目:通过实际开发不断发现问题、解决问题,并沉淀一些 Agent 相关的技术点。
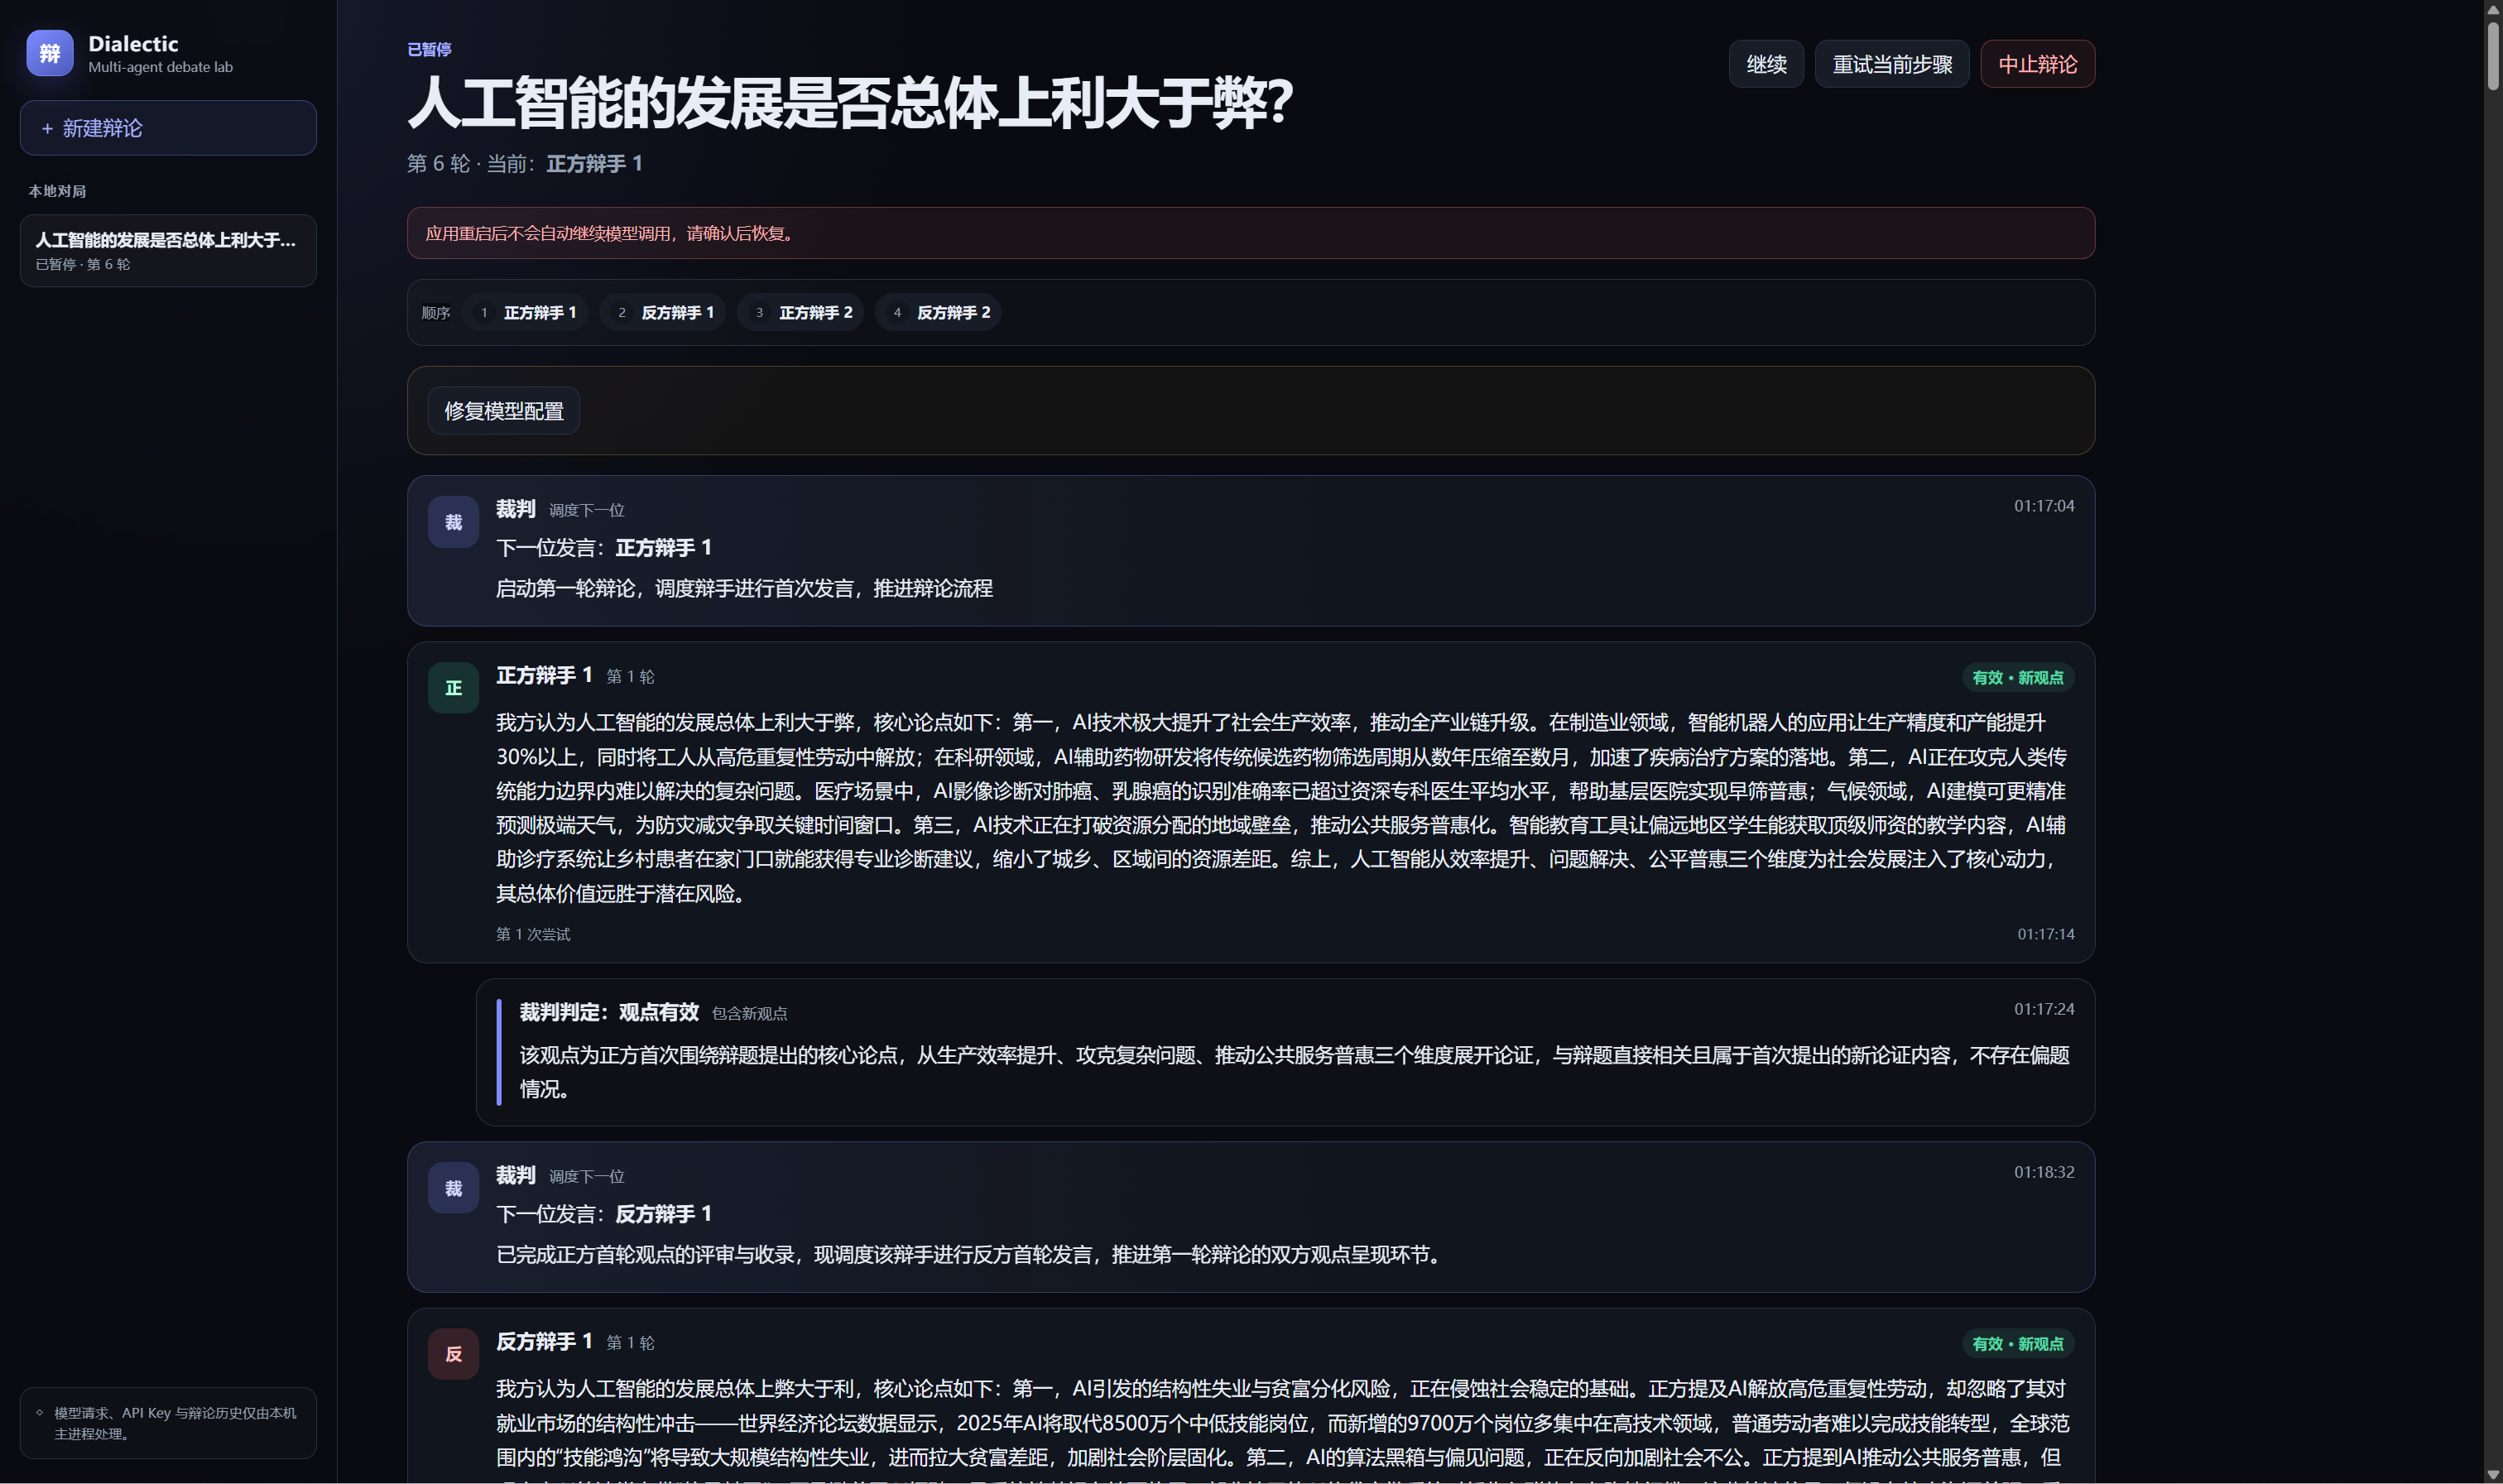
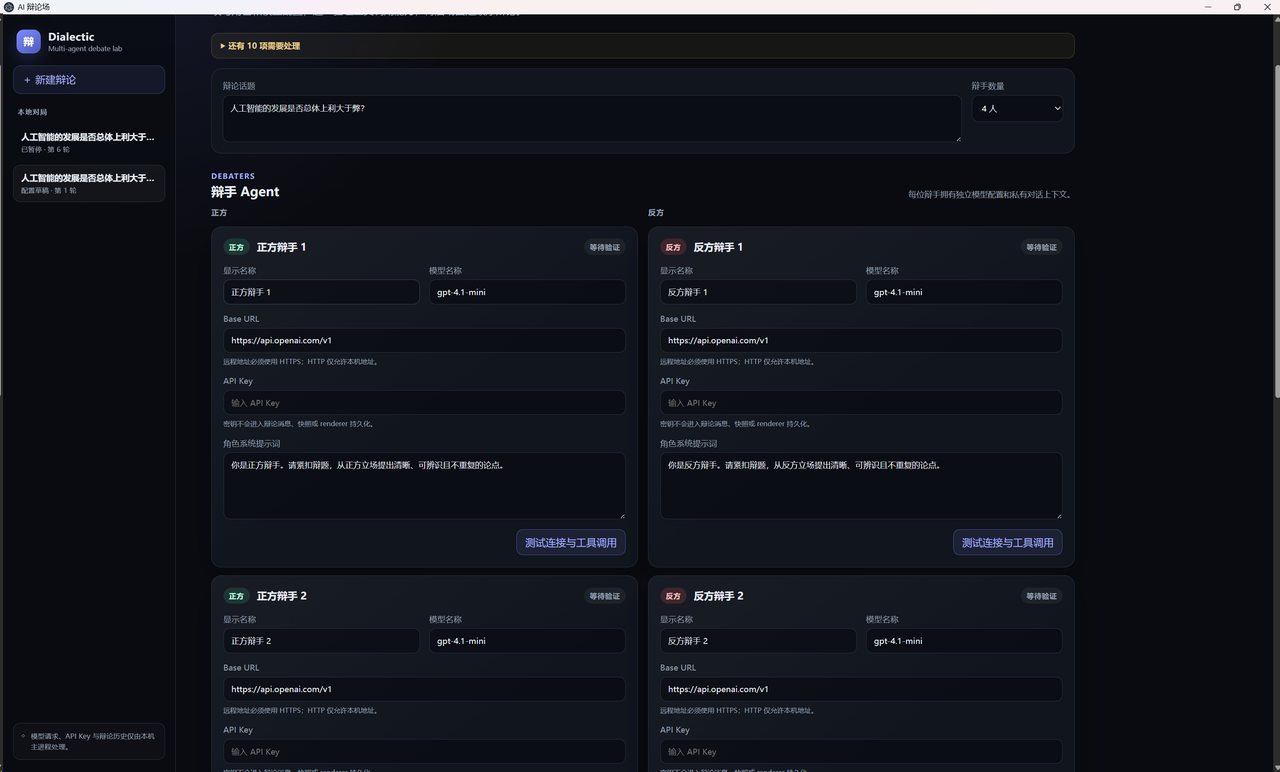
仓库:
https://github.com/Cyfem/ai-debate
在这个过程中,看着我的“博士们”十分卖力地证明自己的观点,我一边欣慰地点头认可,一边也发现了一个比较有意思的点:
辩论的过程,本身也是 AI 不断进行 Review,并根据 Review 结果持续改进的过程。
同时,由于小组内部、正反双方以及裁判之间存在相互约束,看起来也可以从多个角度规避 AI 串行完成任务时比较容易出现的问题:
某一步已经出现了偏差,但 AI 自己没有意识到,最终沿着错误方向继续执行下去。
带着这个想法,我重新梳理了一下思路。
目标变成了:
设计一套用于解决通用问题的 AI 工作流,让 AI 每次完成任务的结果更加可靠,尽可能减少用户后续手动调整的成本。
从 Plan 入手
起初我是从 Plan 入手的。
我的想法是,先设计一套工作流,把 Plan 尽可能迭代完善。
因为如果 Plan 足够细致,同时整体方向没有问题,那么 AI 在后续实际执行过程中出错的概率也会相应降低。
于是,我首先设计了一个应用,用来帮助 AI 迭代 Plan。
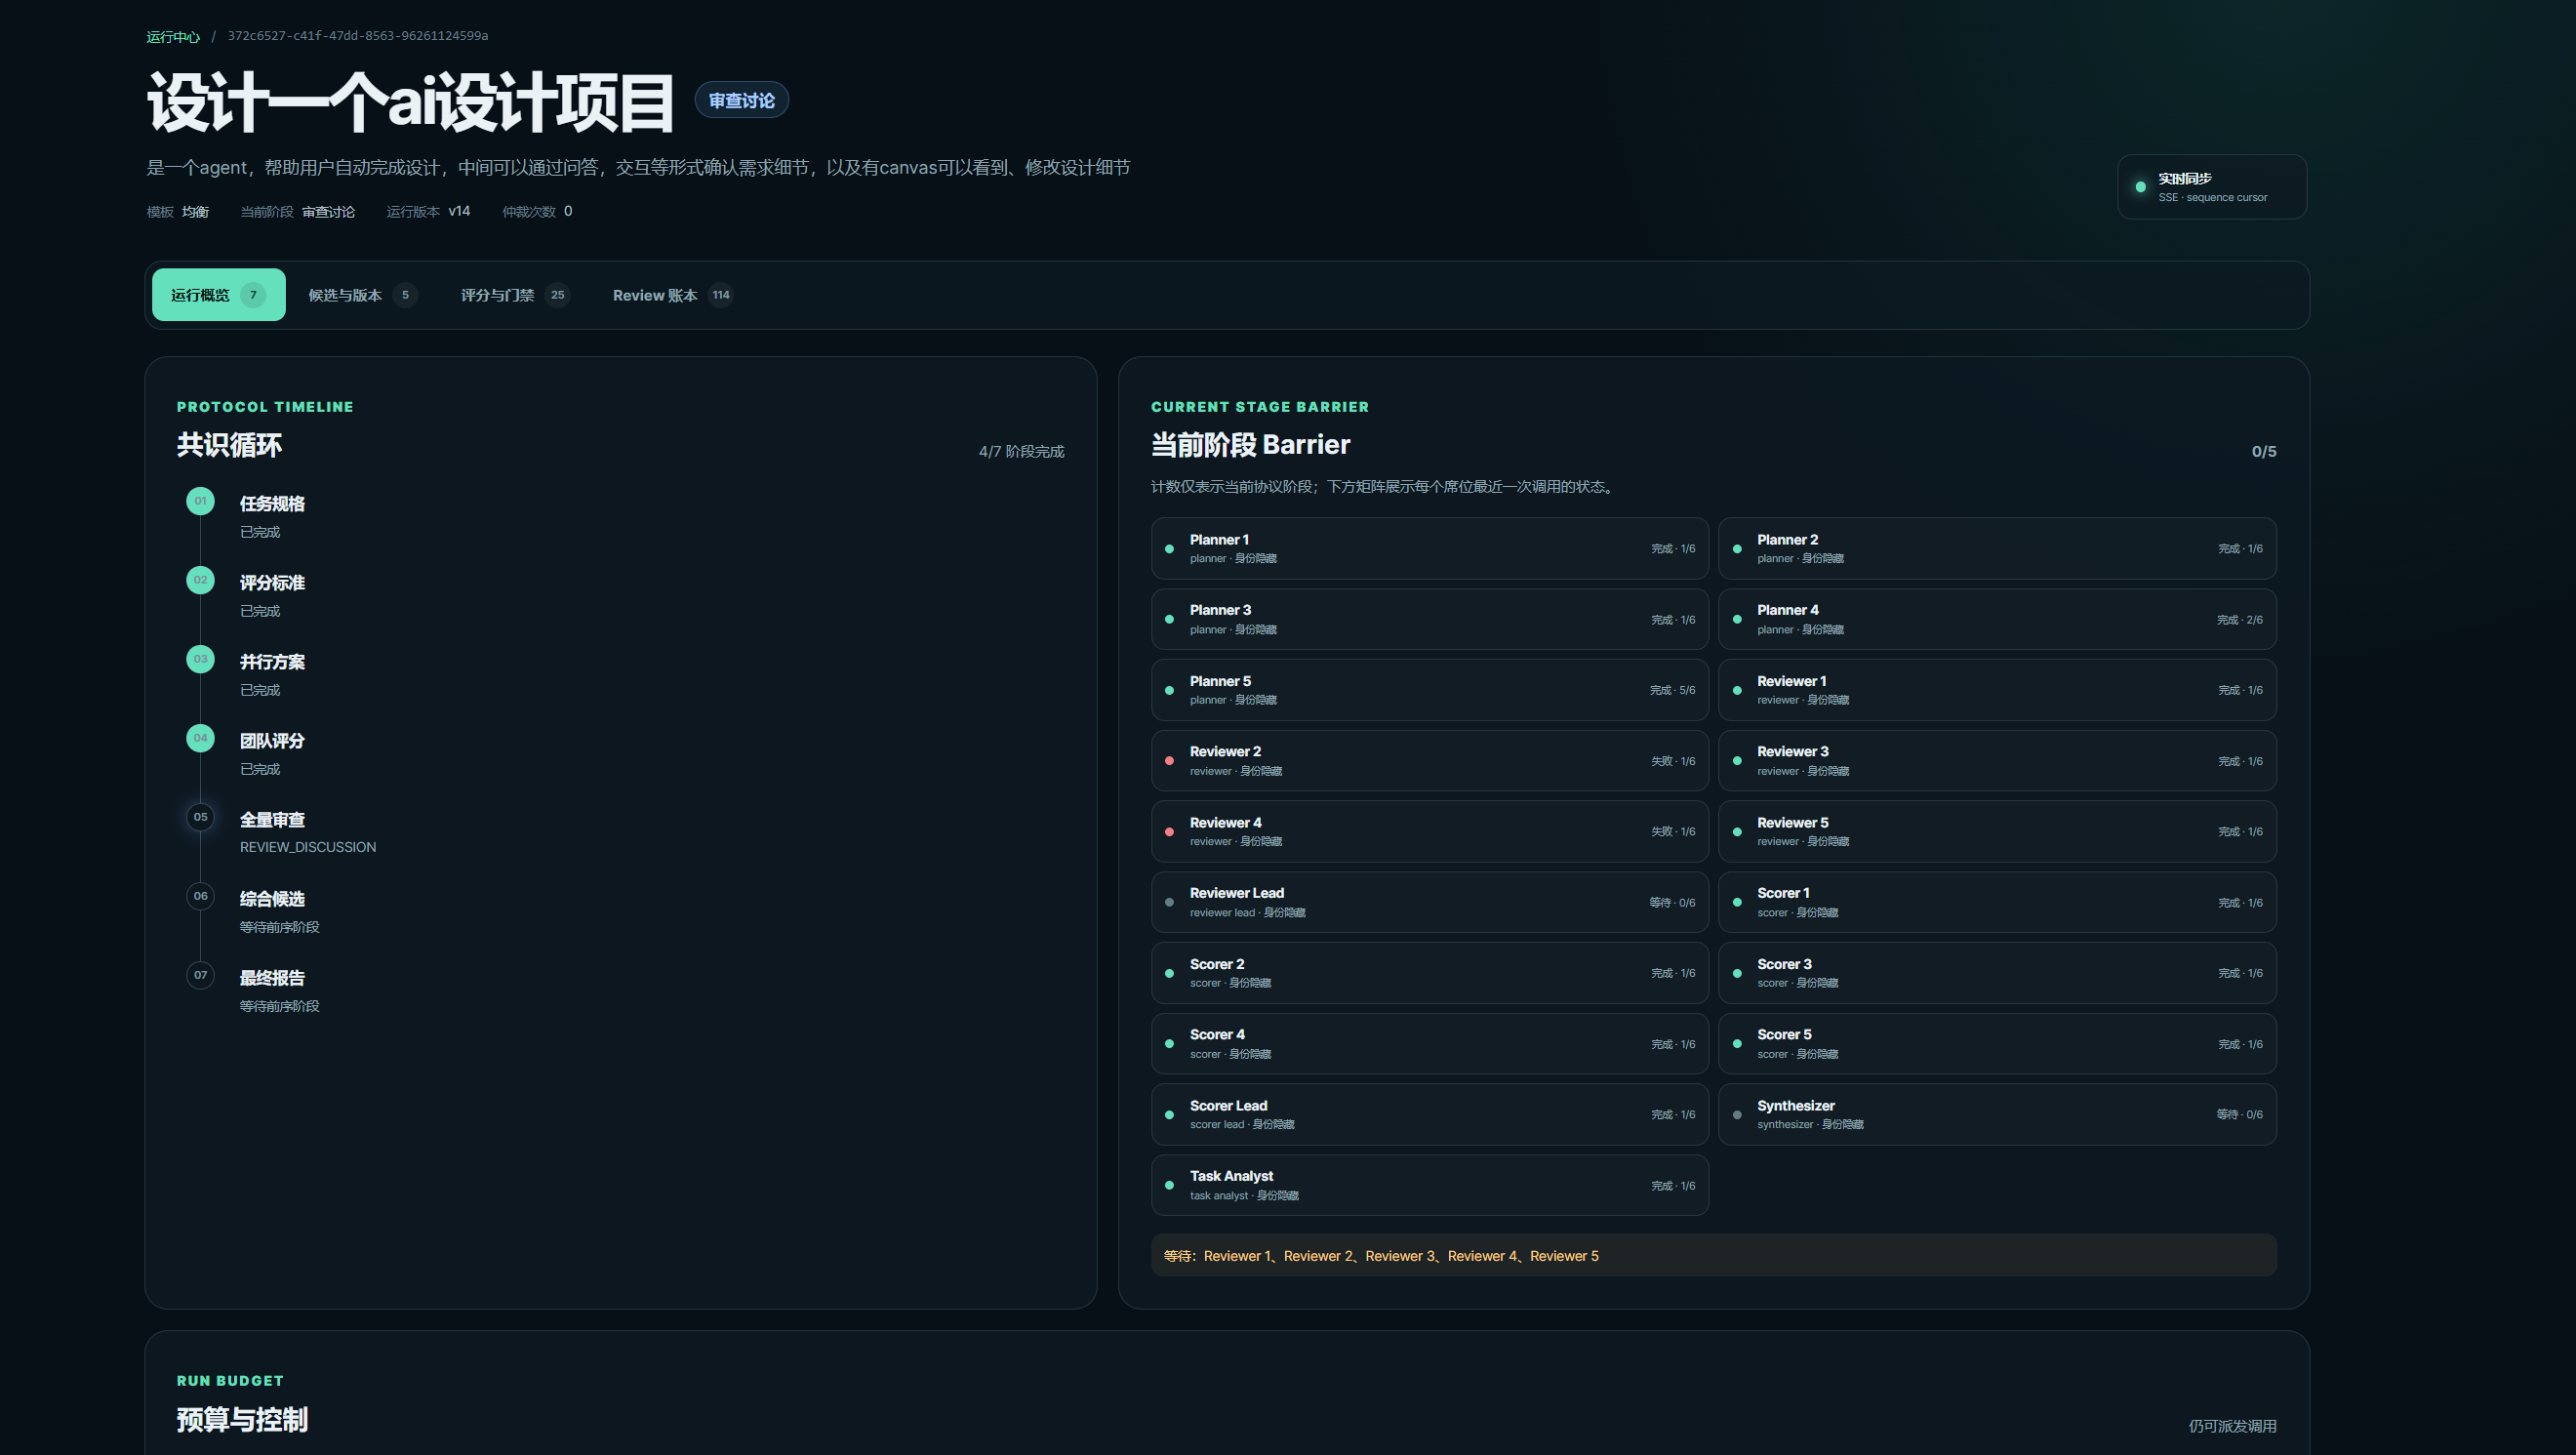
但是继续做下去之后,我发现这个应用的“手”和“脚”并不完善。
这里的“手”和“脚”,主要指:
- Tool
- MCP
- Skill
- Web Fetch
- 以及其他实际任务执行过程中可能需要使用的能力
在真实工作中,AI 还可能需要参考不同的 Skill,调用各种工具,甚至直接操作环境。
因此,更合适的方式应该是:
借助 Codex 这类已经具备较完善 Harness 能力的应用,来承载整个工作流。
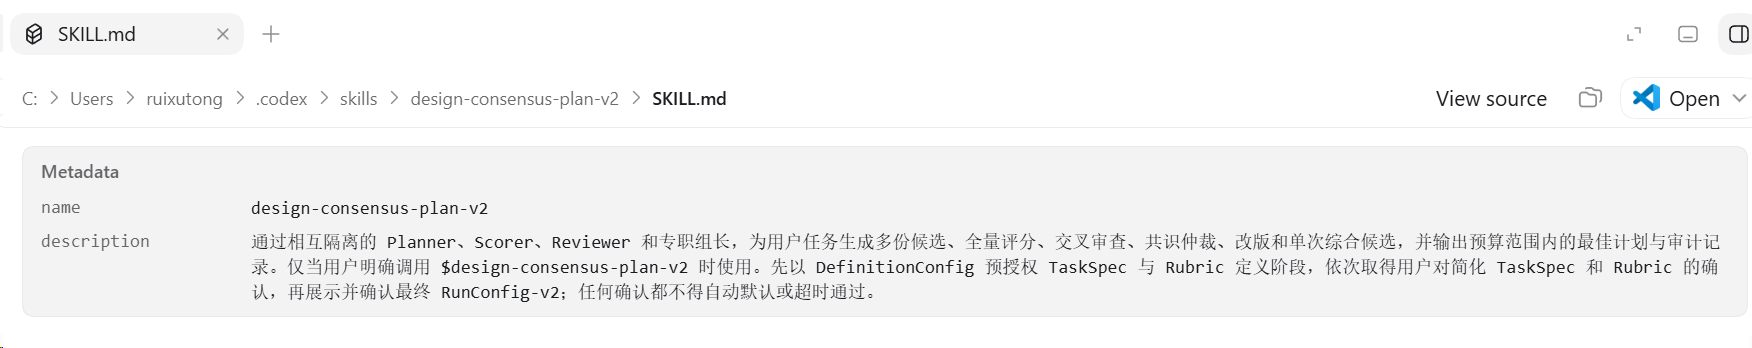
于是,我又基于之前的应用进行了一些调整和问题修复,并将其中的核心工作流抽象成了一个 Skill。
工作流设计
如果整体目标是设计一套尽可能降低出错概率的方案生成流程,我目前将整个流程抽象成了几个小组:
- 任务标准确定组
- 评分规范确定组
- 方案设计组
- Review 组
- 评分组
整体工作流如下。
1. 确定任务标准
首先根据用户输入确定任务标准,例如:
- 目标是什么;
- 有哪些硬性要求;
- 有哪些限制条件;
- 最终需要交付什么。
在这个过程中,如果存在信息不足或者需要进一步确认的地方,也可以与用户进行必要的交互。
2. 确定评分标准
在任务标准明确之后,根据任务标准进一步输出评分规范。
主要包括:
- 需要从哪些维度评价方案;
- 每个维度的评分标准是什么;
- 每个维度分别占多少权重。
后续所有方案都基于这套标准进行评价。
3. 方案设计
接下来由方案设计组开始设计方案。
每个成员需要独立设计自己的方案。
具体采用什么方式并不限制,例如可以:
- Web Fetch
- 使用 Skill
- 调用工具
- 使用 MCP
核心要求只有一个:
每个成员都需要独立产出结果。
4. Review 与初步评分
方案生成完成之后,进入 Review 阶段。
Review 组中的每个成员都会分别对每一个方案进行 Review。
之后,Review 组内部再针对所有 Review 结果进行讨论和辩论。
这个过程主要是为了:
- 去掉误判;
- 去掉本身存在问题的 Review 意见;
- 合并重复问题;
- 对存在争议的问题进一步讨论。
最终形成相对统一的 Review 建议。
与此同时,评分组也会开始对方案进行评分。
不过这一阶段由于方案本身还没有最终确定,因此只进行相对粗略的评分,不会引入过于复杂的辩论流程。
5. 根据 Review 修改方案
方案设计组根据 Review 组给出的建议,对各自的方案进行调整。
调整完成后,再次将方案提交给:
- Review 组;
- 评分组。
然后继续重复前面的流程。
也就是:
Review → 修改 → 再 Review → 再修改
直到 Review 组无法再提出有效的改进建议。
6. 最终评分
当方案基本稳定之后,评分组进行最终评分。
与前面的粗略评分不同,这一阶段的评分会更加严格。
评分组内部会围绕具体评分结果进行讨论和辩论,尽可能确定一个更加合理的最终分数。
最后,根据评分结果:
- 输出所有方案的最终排名;
- 向用户交付多个候选方案;
- 同时给出其中的最优方案。
为什么方案设计组必须独立?
整个设计思路基于一个假设。
假设 AI 完成一次任务后,让用户满意的概率为:
x那么,如果让 AI 相互独立地并行完成 10 次,并假设这 10 次结果之间彼此不相关,那么至少有一次结果让用户满意的概率就是:
1 - (1 - x)^10举个例子。
假设:
x = 10%也就是说,AI 单独完成一次任务,只有 10% 的概率能够命中一个让用户满意的结果。
那么独立完成 10 次之后,至少出现一次满意结果的概率就是:
1 - (1 - 0.1)^10
≈ 65%
也就是说,单次只有 10% 的概率,但是独立尝试 10 次之后,概率可以提升到大约 65%。
当然,这里的前提是:
10 个方案之间确实具有足够的独立性。
这也是为什么我认为方案设计阶段必须相互独立。
如果多个方案实际上在很多关键点上都比较相似,而这些相同的部分本身就是错误的,那么整个工作流也就失去了最初设计它的意义。
我需要的是:
足够多、足够独立、彼此相关性较低的尝试。
为什么 Review 组不采用完全独立的模式?
一个并不那么好的方案,在经过 Review 之后,也有可能逐渐演进成一个比较好的方案。
而在 Review 的过程中,多个成员分别进行检查,也更有可能发现更多问题。
同时,不同 Reviewer 之间还可以互相验证彼此的判断,从而尽可能规避错误 Review 本身带来的影响。
因此,除了方案设计组之外,其他小组我并没有设计成完全独立工作的模式。
也就是说:
它们可以看到彼此的工作过程。
我的考虑是:
这些任务本身是基于一个共同的上下文展开的。
例如在 Review 阶段,一个成员提出了某个问题,其他成员可以继续判断:
- 这个问题是否真的成立;
- 是否存在误判;
- 是否还有其他遗漏;
- 是否需要调整 Review 结论。
在这种情况下,让不同成员能够看到彼此的 Review 点,反而更有利于形成一个质量更高的共识结果。
当前效果
目前从整个工作过程来看,这套机制确实能够自动化地发现并解决不少问题。
不过,最终成果相比于直接让 AI 沿着一条链路生成,到底能够提升多少,目前还没有进行系统评测。
后续我会单独写一篇帖子,对两种方式进行实际对比和评测。
目前这个项目更主要的价值,还是作为我自己学习和验证 Agent Workflow、Harness、多 Agent 协作等相关思路的一次实践。
Skill:
留下你的想法
评论区加载中